El sesgo humano en IA no siempre aparece porque alguien haya diseñado un algoritmo para discriminar.
A veces aparece de una forma mucho más sencilla.
La máquina encuentra información que falta y tiene que decidir qué colocar en ese vacío.
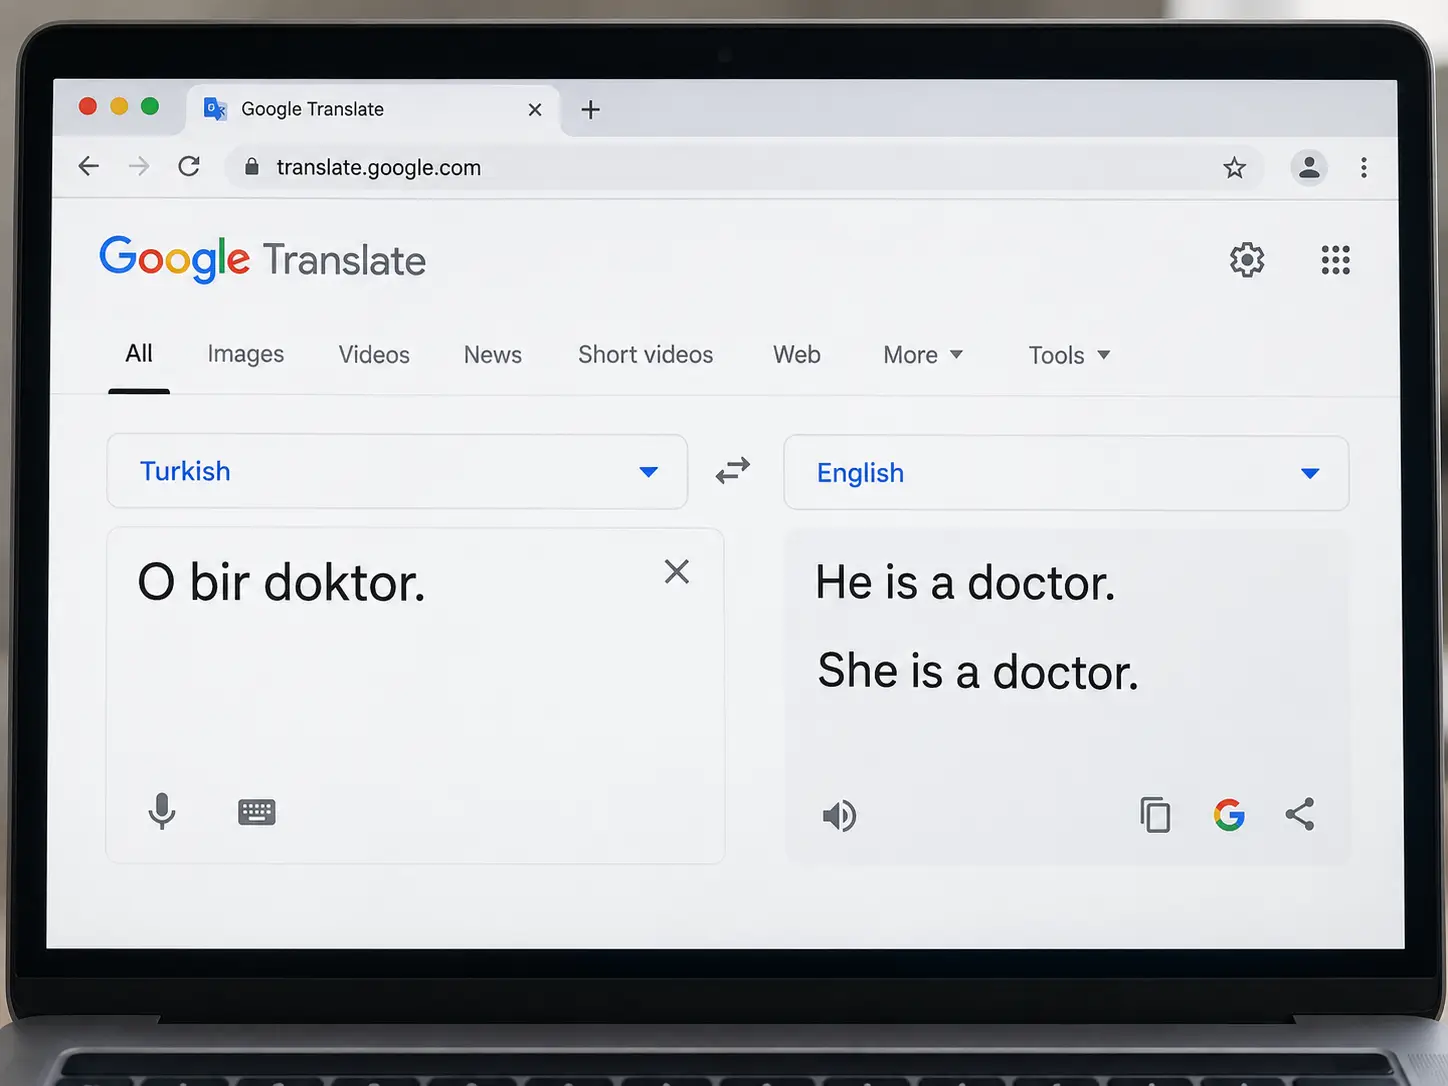
Durante años, uno de los ejemplos más conocidos pudo observarse en Google Translate al traducir determinadas frases del turco al inglés.
En turco, el pronombre “o” no distingue entre masculino y femenino. Una frase como “O bir doktor” no indica si quien ejerce la medicina es un hombre o una mujer.
Sin embargo, al traducirla al inglés, el sistema tenía que escoger.
Y escogía.
Para determinadas profesiones aparecía “he”. Para otras, “she”.
El médico podía convertirse en hombre. La enfermera, en mujer.
El idioma original no había proporcionado esa información.
La máquina la había completado.
Cuando traducir implica tomar una decisión
El problema resulta especialmente interesante porque el modelo no estaba funcionando de manera aparentemente absurda.
Estaba haciendo precisamente aquello para lo que había sido entrenado: encontrar, entre enormes cantidades de ejemplos, la continuación o traducción estadísticamente más probable.
Los sistemas de machine learning aprenden patrones a partir de datos anteriores.
Y esos datos no proceden de una realidad neutral.
Proceden de libros, páginas web, noticias, documentos, conversaciones y traducciones producidas por personas y organizaciones durante años.
En esos datos, algunas profesiones aparecen asociadas con mayor frecuencia a hombres y otras a mujeres. El modelo puede aprender esa relación.
No necesita comprender el estereotipo.
Sólo necesita encontrar el patrón.
Ahí se produce un cambio importante.
Un sesgo humano deja de ser únicamente una característica de la sociedad y pasa a convertirse en un reto técnico.
Del sesgo humano en IA al sesgo algorítmico
Se tiende a imaginar que los datos son una representación objetiva del mundo.
Pero los datos son, en realidad, rastros de cómo ese mundo ha funcionado.
Contienen decisiones anteriores, desigualdades, hábitos, estructuras económicas, formas de escribir y maneras de clasificar la realidad.
El algoritmo aprende de todo ello.
Por eso, entrenar un modelo con grandes cantidades de información no garantiza necesariamente mayor neutralidad.
En algunos casos puede ocurrir exactamente lo contrario.
Cuantos más ejemplos históricos se proporcionan, con mayor precisión puede aprenderse también un patrón histórico que no se desea reproducir.
El sesgo algorítmico no significa que la máquina tenga prejuicios. Al menos, no en el sentido humano del término.
Surge porque ha aprendido una regularidad y la utiliza para resolver una incertidumbre.
Y esa diferencia importa.
Porque significa que corregir el problema no consiste únicamente en eliminar algunos datos considerados incorrectos.
Google Translate también tuvo que aprender a no asumir
Google reconoció este problema y comenzó a introducir en 2018 traducciones específicas por género para determinados idiomas.
En lugar de obligar al sistema a elegir una única interpretación cuando la frase original era neutral, comenzaron a mostrarse alternativas masculinas y femeninas.
La solución parece sencilla una vez formulada.
Técnicamente, no lo era.
Había que detectar cuándo una frase era realmente neutral respecto al género, generar diferentes traducciones y comprobar además que ambas conservaran el mismo significado.
El caso muestra algo especialmente interesante sobre el desarrollo de inteligencia artificial.
A veces mejorar un sistema no significa conseguir que prediga mejor.
Significa enseñarle cuándo no debería predecir aquello que no sabe.
El problema no ha desaparecido
La evolución de los sistemas de traducción tampoco convierte este ejemplo en una simple anécdota de los primeros años del machine learning.
Investigaciones posteriores han continuado estudiando cómo los modelos asignan género cuando la información original es ambigua.
En 2026, un estudio centrado precisamente en traducciones desde el turco analizó miles de frases en distintos sistemas de traducción.
Incluso cuando no existían señales explícitas de género, los modelos mostraban con frecuencia resultados consistentes con estereotipos profesionales.
La tecnología cambia.
El problema fundamental permanece.
Cuando falta información, un modelo necesita algún mecanismo para gestionar esa incertidumbre.
Y si ese mecanismo se basa únicamente en lo que ocurrió con mayor frecuencia en el pasado, el pasado puede terminar convertido en predicción.
Los datos describen el mundo, pero también pueden congelarlo
Aquí aparece una de las cuestiones más interesantes del sesgo en machine learning.
Existe una diferencia entre describir estadísticamente una realidad y decidir que esa realidad debe convertirse en el comportamiento futuro de un sistema.
Puede ser cierto que históricamente una profesión haya estado ocupada mayoritariamente por un determinado género.
Pero de esa observación no se deriva necesariamente que un algoritmo deba utilizar el género como respuesta cuando la información original no lo especifica.
La estadística responde a una pregunta:
¿qué ocurrió con mayor frecuencia?
El diseño tecnológico debe plantearse otra:
¿es apropiado utilizar esa frecuencia para tomar esta decisión?
No son la misma pregunta, y probablemente tampoco se obtenga la misma respuesta.
La inteligencia artificial no elimina las decisiones humanas
Cuanto más sofisticados se vuelven los sistemas de inteligencia artificial, más fácil resulta pensar que determinadas decisiones han pasado de las personas a las máquinas.
En realidad, muchas simplemente han cambiado de lugar.
Están en la selección de los datos.
En las variables que se utilizan.
En aquello que se considera una respuesta correcta.
En cómo se resuelve una ambigüedad.
En los límites que se incorporan al modelo.
Y también en la decisión de cuándo un sistema debería reconocer que no dispone de información suficiente.
Por eso, el sesgo humano en IA no puede entenderse únicamente como un fallo del algoritmo.
Es un reto sociotécnico: aparece en la relación entre datos, tecnología, decisiones de diseño y la sociedad de la que todos ellos proceden.
Quizá la pregunta más interesante sea precisamente la que todavía estamos aprendiendo a responder:
Cuando una máquina necesita completar aquello que no sabe, ¿qué parte de nuestra realidad estamos permitiendo que utilice como respuesta?