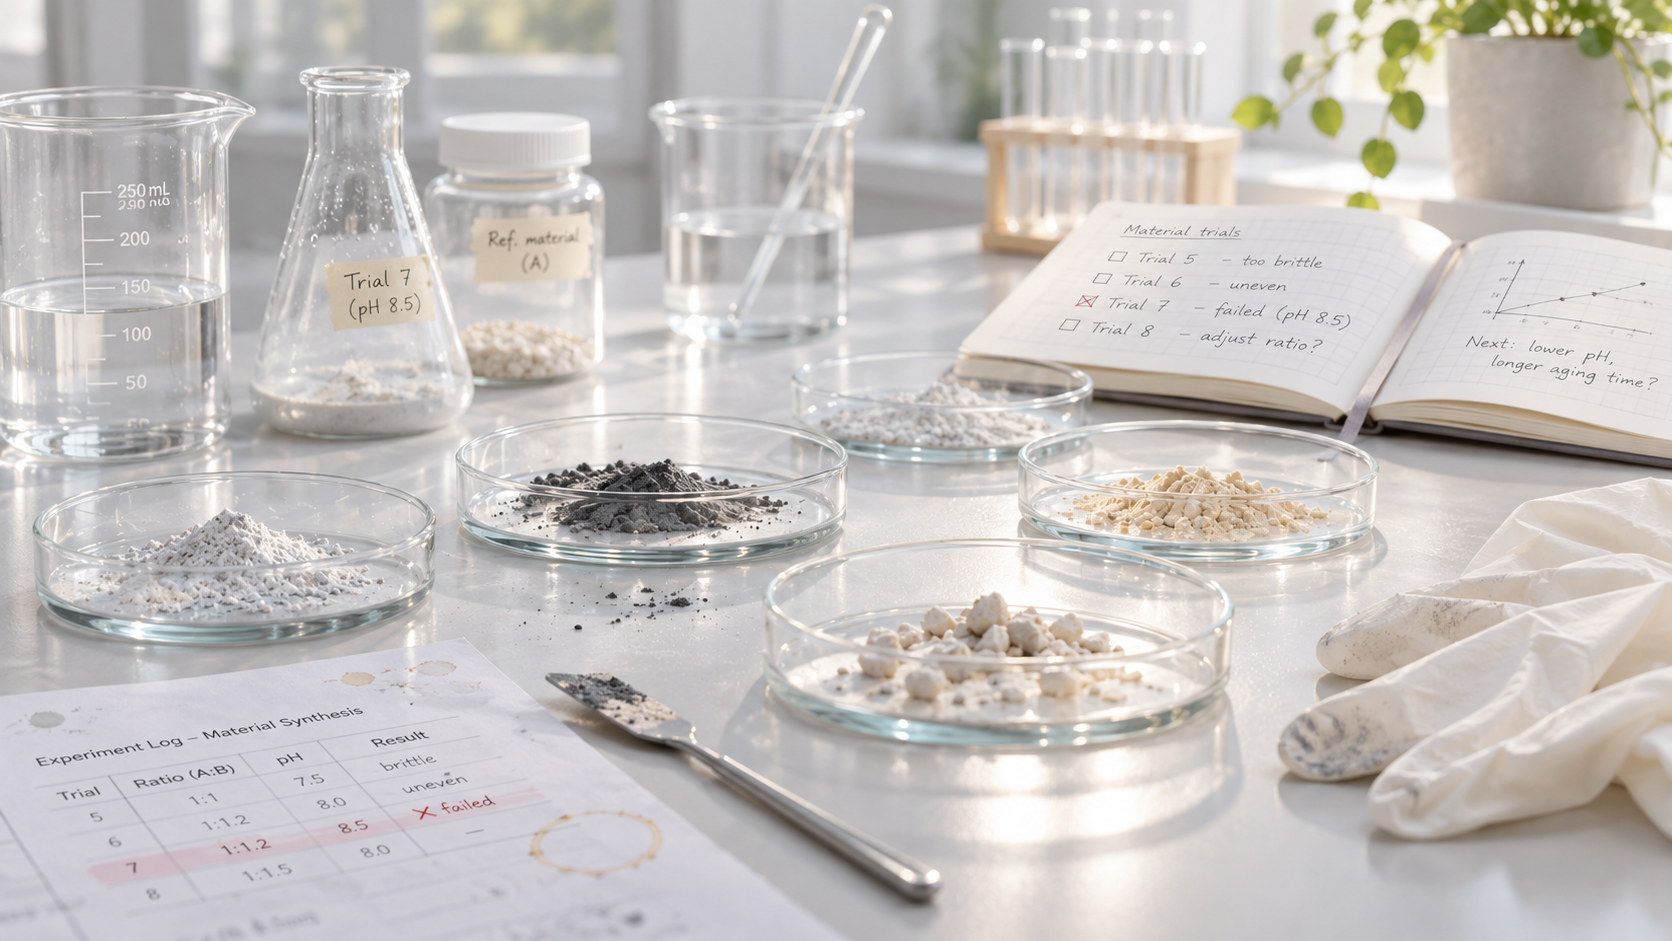
En un laboratorio, un experimento termina sin obtener el resultado esperado.
Se revisan las condiciones, se comprueban los cálculos y se repite el procedimiento. El resultado vuelve a ser negativo.
La investigación continúa hasta encontrar una combinación que funciona. Finalmente, se publica el descubrimiento.
Pero ¿qué ocurre con todos los intentos anteriores?
En muchas ocasiones, permanecen en cuadernos de laboratorio, bases de datos internas o archivos que nunca llegan a publicarse.
Y esto plantea una cuestión especialmente relevante en la era de la inteligencia artificial:
¿Puede una máquina aprender de nuestros errores si sólo le enseñamos nuestros éxitos?
La ciencia también tiene un problema de selección
En 1979, el psicólogo Robert Rosenthal describió lo que denominó el file drawer problem, o problema del cajón de archivos.
Su planteamiento era sencillo: los estudios que encuentran resultados estadísticamente significativos tienen más posibilidades de publicarse que aquellos que no los encuentran.
Esto introduce una distorsión en la literatura científica.
Cuando se imagina veinte equipos independientes que investigan una misma hipótesis. Diecinueve no encuentran evidencias suficientes para respaldarla, mientras que uno obtiene un resultado aparentemente positivo.
Si únicamente se publica este último, la literatura disponible ofrecerá una imagen muy diferente de lo que realmente ocurrió.
El problema no está necesariamente en los experimentos individuales, sino en la información que finalmente llega a formar parte del conocimiento compartido.
Lo que se publica no siempre representa todo lo que se ha investigado.
¿Un experimento fallido es realmente un fracaso?
En investigación científica conviene distinguir entre un experimento mal ejecutado y uno que no confirma la hipótesis inicial.
El primero puede carecer de valor si sus resultados no son fiables.
El segundo, cuando está correctamente diseñado y documentado, puede aportar información fundamental.
No conseguir sintetizar un determinado material bajo unas condiciones específicas permite descartar posibilidades, identificar limitaciones y orientar nuevas investigaciones.
En ocasiones, conocer dónde no aparece un fenómeno es tan importante como conocer dónde sí aparece.
Sin embargo, los incentivos académicos han favorecido históricamente la publicación de resultados novedosos, significativos y positivos.
Esta tendencia puede generar una pérdida de conocimiento que rara vez se contabiliza.
¿Cuántos recursos se dedican a repetir experimentos cuyos resultados negativos ya eran conocidos por otros investigadores, pero nunca fueron compartidos?
Cuando los experimentos fallidos se convierten en datos valiosos
En 2016, un equipo de investigadores liderado por Paul Raccuglia publicó en Nature un estudio especialmente ilustrativo.
Los científicos recuperaron información sobre reacciones químicas fallidas que había permanecido archivada en cuadernos de laboratorio.
En lugar de descartarla, utilizaron estos registros para entrenar un modelo de aprendizaje automático capaz de predecir los resultados de nuevas reacciones.
Al evaluar nuevas condiciones experimentales, el sistema alcanzó una tasa de éxito del 89% en la formación de determinados materiales inorgánicos, superando las estrategias humanas utilizadas como referencia.
Lo interesante no era únicamente la capacidad predictiva del modelo.
Era el origen de una parte esencial de su conocimiento.
Los datos que tradicionalmente se habían considerado poco útiles permitieron mejorar la selección de nuevos experimentos.
Aquellos resultados no habían dejado de tener valor científico.
Simplemente no se estaban aprovechando.
La inteligencia artificial aprende de la realidad que registramos
Los modelos de aprendizaje automático identifican relaciones y patrones en los datos disponibles.
Pero esos datos no siempre constituyen una representación completa del fenómeno que intentan describir.
Si los registros científicos contienen principalmente experimentos exitosos, los modelos pueden encontrar dificultades para reconocer las condiciones asociadas al fracaso.
El problema se vuelve especialmente importante en investigación de materiales, química, biotecnología o desarrollo energético, donde cada experimento puede requerir recursos significativos.
En 2023, un estudio publicado en Nature presentó A-Lab, un laboratorio autónomo que combinaba robótica, aprendizaje automático y conocimiento científico previo para sintetizar materiales inorgánicos.
De los 57 materiales seleccionados, consiguió sintetizar 36. Otros 17 no pudieron obtenerse y cuatro presentaron resultados inconclusos.
Lejos de ignorar estos resultados, los investigadores analizaron las dificultades experimentales y computacionales encontradas.
Los intentos no satisfactorios permitieron identificar limitaciones y posibles mejoras del proceso.
La inteligencia artificial no eliminaba la necesidad de experimentar.
Ayudaba a decidir mejor qué experimentar después.
¿Estamos construyendo una memoria científica incompleta?
El problema trasciende la investigación académica.
En las organizaciones industriales también se documentan con mayor facilidad los proyectos exitosos, las soluciones implantadas y las mejoras conseguidas.
Los pilotos abandonados, las hipótesis descartadas y las decisiones que no produjeron los efectos esperados suelen recibir menos atención.
Sin embargo, esa información contiene conocimiento sobre restricciones técnicas, decisiones anteriores y condiciones que convendría no repetir.
Si una organización utiliza inteligencia artificial para consultar su conocimiento interno, pero únicamente conserva sus éxitos: ¿qué comprensión de su propia experiencia está transmitiendo al sistema?
La cuestión no es almacenar indiscriminadamente todos los errores.
Es identificar cuáles ofrecen información verificable, contextualizada y reutilizable.
El progreso también necesita publicar lo que no funciona
Existen iniciativas que buscan reducir esta distorsión.
Los Registered Reports, por ejemplo, permiten que determinadas investigaciones sean evaluadas por la calidad de su pregunta y metodología antes de conocer sus resultados.
Su objetivo es que la publicación no dependa exclusivamente de que la hipótesis termine siendo confirmada.
Este enfoque introduce un cambio relevante: reconocer que una investigación rigurosa puede ser valiosa incluso cuando no encuentra aquello que esperaba.
La inteligencia artificial puede acelerar extraordinariamente el descubrimiento científico.
Pero esa capacidad dependerá también de la calidad, diversidad y representatividad de la información que utilicemos para desarrollarla.
Los próximos grandes retos no consistirán únicamente en producir más conocimiento, sino en evitar que una parte del conocimiento que ya hemos generado desaparezca por no ajustarse a nuestras expectativas.
Porque, si sólo conservamos aquello que confirma nuestras hipótesis, ¿estamos enseñando a la inteligencia artificial cómo funciona la realidad o cómo nos gustaría que funcionará?
Referencias
Rosenthal, R. (1979). The file drawer problem and tolerance for null results. Psychological Bulletin, 86(3), 638–641.
Raccuglia, P., Elbert, K. C., Adler, P. D. F., et al. (2016). Machine-learning-assisted materials discovery using failed experiments. Nature, 533, 73–76.
Szymanski, N. J., Rendy, B., Fei, Y., et al. (2023). An autonomous laboratory for the accelerated synthesis of inorganic materials. Nature, 624, 86–91.
Center for Open Science. Registered Reports: Peer review before results are known.
Descubre más desde Noelia Varela | Transformación, innovación y tecnología
Suscríbete y recibe las últimas entradas en tu correo electrónico.