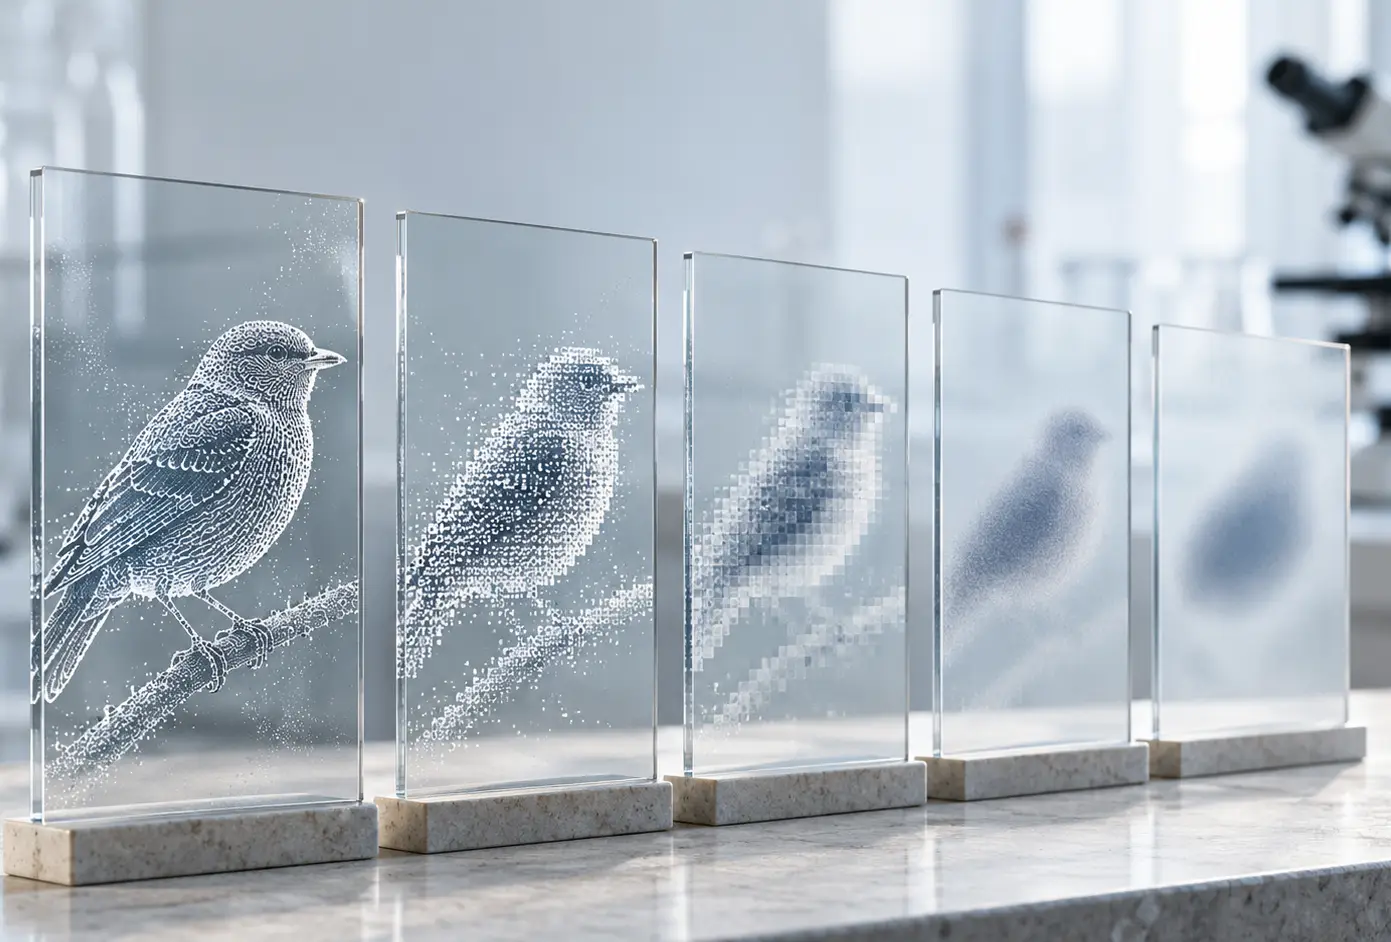
Imaginemos una biblioteca en la que, cada cierto tiempo, los libros originales son sustituidos por resúmenes elaborados a partir de los anteriores.
En la primera generación, los textos probablemente conservarían buena parte del conocimiento original. En la segunda, comenzarían a desaparecer algunos matices. Después de varias generaciones, determinados detalles podrían perderse y algunas interpretaciones acabarían convirtiéndose en aparentes certezas.
La biblioteca seguiría creciendo. Incluso podría parecer cada vez más ordenada.
Pero ¿estaría conservando el conocimiento o construyendo una versión progresivamente simplificada de él?
Esta analogía permite aproximarse a uno de los desafíos de la inteligencia artificial generativa: el entrenamiento de modelos con datos sintéticos producidos por otras inteligencias artificiales.
Cuando los datos dejan de proceder directamente de la realidad
Los modelos de inteligencia artificial aprenden identificando patrones en grandes conjuntos de información.
Históricamente, una parte importante de esos datos procedía de textos, fotografías, investigaciones, conversaciones y otros registros de actividad humana.
Sin embargo, la inteligencia artificial generativa está modificando el origen de una parte creciente del contenido digital.
Artículos, imágenes, vídeos y documentos pueden producirse automáticamente, distribuirse en internet y terminar incorporándose a futuros conjuntos de entrenamiento.
Surge así una situación particular: los modelos pueden acabar aprendiendo de información elaborada por sus predecesores.
Estos contenidos forman parte de lo que se conoce como datos sintéticos, aunque no todos los datos sintéticos tienen el mismo origen ni presentan los mismos riesgos.
El problema aparece cuando las representaciones generadas por una IA sustituyen progresivamente a las observaciones originales sin suficientes mecanismos de control.
El colapso de los modelos: aprender hasta olvidar
En julio de 2024, un equipo de investigadores de las universidades de Oxford y Cambridge, junto con otras instituciones, publicó en Nature el estudio AI models collapse when trained on recursively generated data.
La investigación analizó qué sucede cuando sucesivas generaciones de modelos se entrenan utilizando información generada por modelos anteriores.
Los resultados mostraron que, bajo determinadas condiciones, el entrenamiento recursivo puede provocar un fenómeno denominado model collapse, o colapso de modelos.
Una de sus consecuencias más interesantes es la desaparición progresiva de los acontecimientos menos frecuentes dentro de los datos.
Los modelos tienden a reproducir patrones estadísticamente probables. Cuando sus resultados se utilizan repetidamente como material de aprendizaje, algunas particularidades de la información original pueden perder representación.
No significa necesariamente que el modelo deje de producir respuestas coherentes.
Puede continuar generando textos perfectamente estructurados mientras pierde capacidad para representar determinados aspectos de la realidad.
Y aquí aparece una paradoja.
Un sistema puede seguir produciendo información convincente mientras disminuye la diversidad del conocimiento que es capaz de representar.
Los datos sintéticos no son el enemigo
Sería un error interpretar estos resultados como una demostración de que los datos sintéticos perjudican necesariamente a la inteligencia artificial.
En entornos industriales, médicos o energéticos, generar información artificial puede resultar especialmente valioso.
Por ejemplo, un modelo predictivo podría beneficiarse de escenarios simulados de funcionamiento de una instalación, incluyendo situaciones excepcionales que apenas aparecen en los registros históricos.
La simulación permite ampliar las posibilidades de experimentación sin necesidad de reproducir físicamente cada escenario.
La diferencia fundamental está en cómo se generan, seleccionan y validan esos datos.
Una investigación de Gerstgrasser y colaboradores, publicada en 2024, cuestionó que el colapso fuera inevitable. Sus resultados mostraron que conservar y acumular datos reales junto con los sintéticos puede evitar determinados procesos de degradación en los escenarios estudiados.
Más recientemente, en julio de 2026, investigadores publicaron en npj Artificial Intelligence una propuesta denominada ForTIFAI, basada en modificar el proceso de aprendizaje para reducir el efecto de determinadas predicciones excesivamente seguras.
En sus experimentos, la técnica permitió tolerar más del doble de exposición a datos sintéticos antes de alcanzar el umbral de deterioro analizado.
La investigación, por tanto, no apunta a abandonar los datos sintéticos, sino a comprender mejor las condiciones que permiten utilizarlos sin comprometer la calidad del aprendizaje.
¿Qué ocurre con aquello que es excepcional?
El problema tiene una dimensión que trasciende la ingeniería de modelos.
En cualquier conjunto de datos existen acontecimientos habituales y otros extraordinariamente infrecuentes.
Pero lo poco frecuente no es necesariamente poco importante.
Una anomalía industrial, una combinación excepcional de variables ambientales o un comportamiento minoritario pueden contener información decisiva.
Cuando un sistema pierde progresivamente la capacidad de representar estos casos, no solo reduce su diversidad estadística.
También puede empobrecer su capacidad de reconocer situaciones distintas de aquellas que predominan en su entrenamiento.
En un contexto empresarial, esta cuestión resulta especialmente relevante.
Los modelos predictivos no deberían limitarse a reproducir lo que ocurre con mayor frecuencia. En muchas aplicaciones, su verdadero valor está precisamente en anticipar lo que sucede pocas veces, pero tiene consecuencias importantes.
La procedencia de los datos como ventaja estratégica
El crecimiento de los datos sintéticos también obliga a reconsiderar qué significa disponer de información de calidad.
Durante años, el desarrollo tecnológico se ha asociado a la capacidad de recopilar y procesar cantidades crecientes de datos.
Sin embargo, la abundancia no garantiza representatividad, diversidad ni fiabilidad.
Resulta necesario conocer de dónde procede la información, cómo se ha transformado y qué mecanismos permiten contrastarla con observaciones independientes.
En este escenario, los registros originales, la trazabilidad y la validación adquieren un valor estratégico.
No porque la información generada artificialmente carezca de utilidad, sino porque una representación de la realidad no debería confundirse automáticamente con la realidad que pretende describir.
Una inteligencia que necesita seguir mirando al mundo
La posibilidad de generar cantidades prácticamente ilimitadas de contenido introduce una nueva dificultad.
Producir información será cada vez más sencillo. Determinar qué información aporta conocimiento fiable puede convertirse en una tarea mucho más exigente.
El futuro de la inteligencia artificial no dependerá únicamente de desarrollar modelos más grandes, rápidos o eficientes.
También dependerá de conservar su conexión con aquello que intentan comprender.
La investigación sobre el colapso de modelos recuerda que aprender no consiste simplemente en procesar más información, sino en mantener la calidad y la diversidad de las referencias utilizadas.
Por eso la pregunta más importante no sea cuántos datos podrá generar una inteligencia artificial.
Sino otra mucho más fundamental:
¿De qué sirve una inteligencia capaz de producir infinitas respuestas si cada vez dispone de menos realidad de la que aprender?
Referencias
- Shumailov, I., Shumaylov, Z., Zhao, Y., et al. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755–759.
- Gerstgrasser, M., Schaeffer, R., Dey, A., et al. (2024). Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data. arXiv.
-
Zibakhsh Shabgahi, S., Aghazadeh, P., Mirhoseini, A., et al. (2026). ForTIFAI: fending off recursive training induced failure for AI model collapse. npj Artificial Intelligence, 2, artículo 70.